なぜCEOの質問に、違う数字が返ってくるのか――データ基盤とダッシュボード運用
1. 導入:CEOの質問に、なぜ違う数字が返ってくるのか
Airbnbではかつて、CEOのBrian Cheskyが「先週、最も予約が多かった都市はどこか」と尋ねると、データサイエンスと財務から異なる答えが返ってくることがあった。同社の公式Engineering Blogによれば、両チームは微妙に異なるテーブル、指標定義、ビジネスロジックを使っていた。単純な質問に見えても、社内には一つの答えが存在しなかったのである。[1]
これは悪意や技術力不足による失敗ではない。事業が成長すると、財務は締め処理に適した予約数を必要とし、プロダクトチームは施策の反応を早く見るための予約数を必要とする。それぞれが仕事を進めるために集計を作った結果、同じ名前を持つ別の指標が生まれる。 データの入口が同じでも、加工と定義の経路が分かれれば、出口の数字も分かれる。
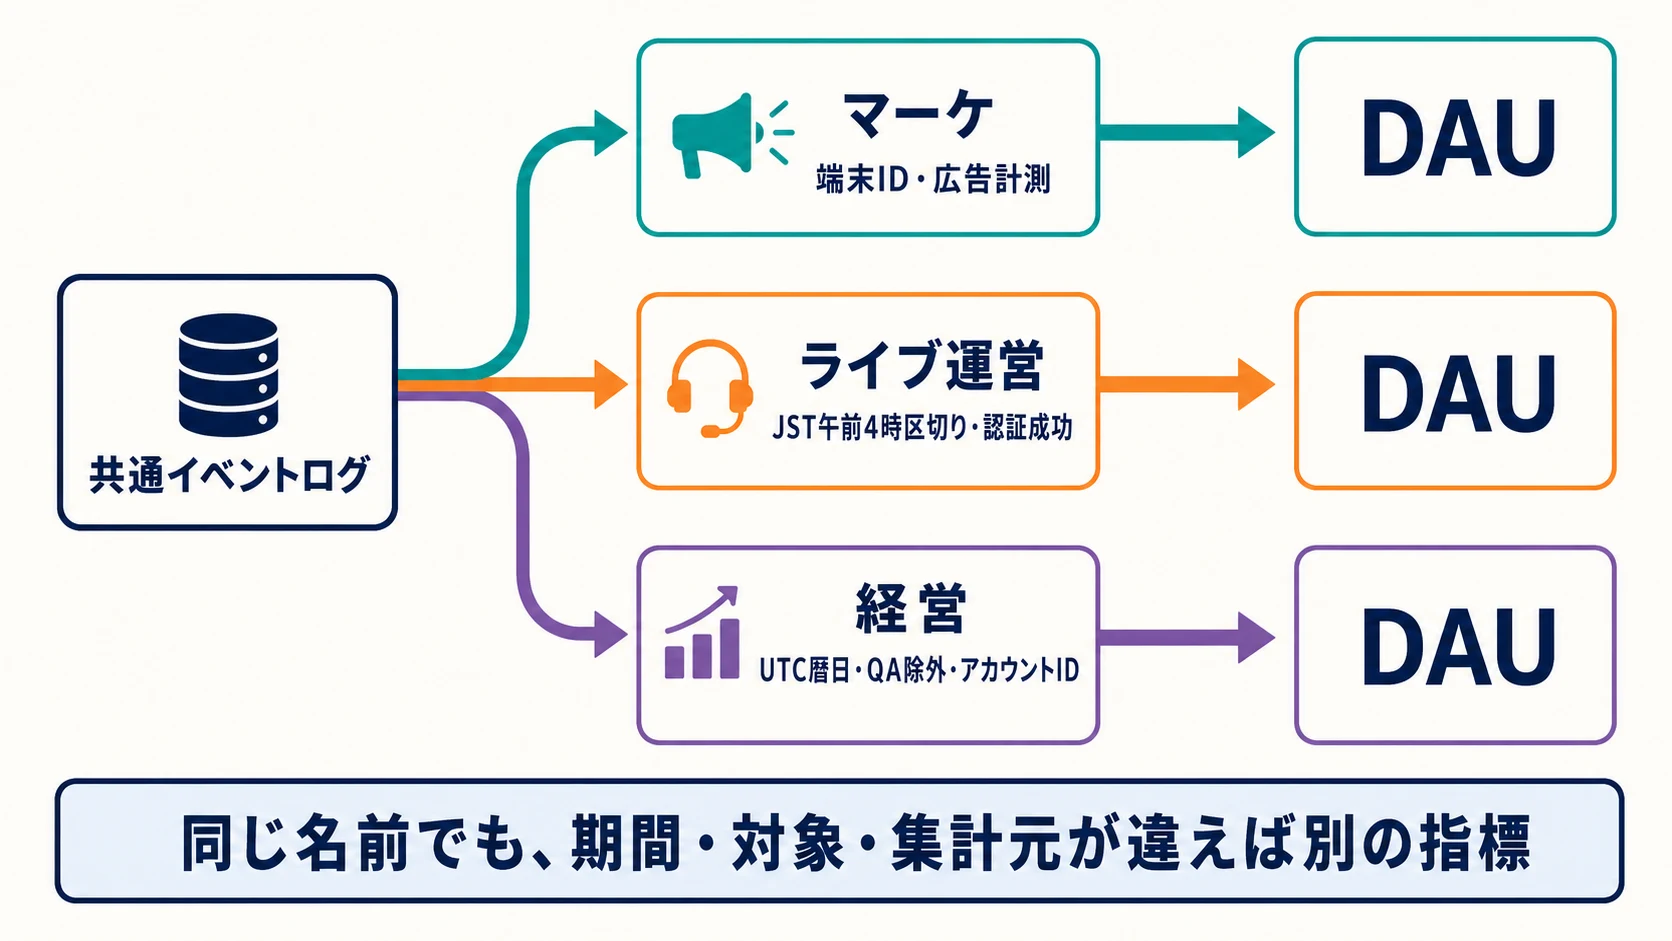
ゲーム会社でも構造は同じである。マーケティングが広告効果を見るために使うDAU、ライブ運営が日次リセット単位で見るDAU、経営会議が会計上の地域区分で見るDAUは、同じ名称でも対象期間や除外条件が異なりうる。会議で「どれが正しいのか」を争う前に、各数字がどのログ、どのテーブル、どの定義から作られたかをたどる必要がある。
ゲームプランナーが知っておくべきデータベースの基礎は、ゲーム本体がユーザーデータを安全かつ高速に読み書きするためのプロダクションDBを扱った。本稿が扱うのは、そのDBやイベントログから分析用の複製・加工データを作り、KPIとして配布する別の系統である。プランナーが理解すべき到達点は、製品ごとの実装詳細ではなく、 数字がどこで作られ、どこで意味を与えられ、誰が保守するのか を確認できることである。
2. パイプラインの基本構造――イベントログはどうダッシュボードになるか
ダッシュボードに折れ線グラフが表示されるまでには、概ね次の四段階がある。
- イベントログを発生させる:起動、ログイン、ステージ開始、購入完了などをゲームやサーバーが記録する。
- ETLで運ぶ・整える:ETLはExtract、Transform、Loadの略である。プランナー向けには「必要なデータを取り出し、分析できる形へ整え、集計先へ運ぶ工程」と捉えればよい。
- DWHへ蓄積する:データウェアハウス(DWH)は、分析用データを横断的に検索するための保管・計算場所である。
- BIで可視化する:BI(Business Intelligence)ツールが、DWHへの問い合わせ結果を表やグラフとして共有する。
テレメトリ・計測設計入門が扱うのは主に第1段階の「何を、いつ、どの粒度で記録するか」である。本稿は、そのログが第2段階以降を通って意思決定用の数字になるまでを追う。
DeNAの例:社内の多様な事業を一本の流れへ載せる
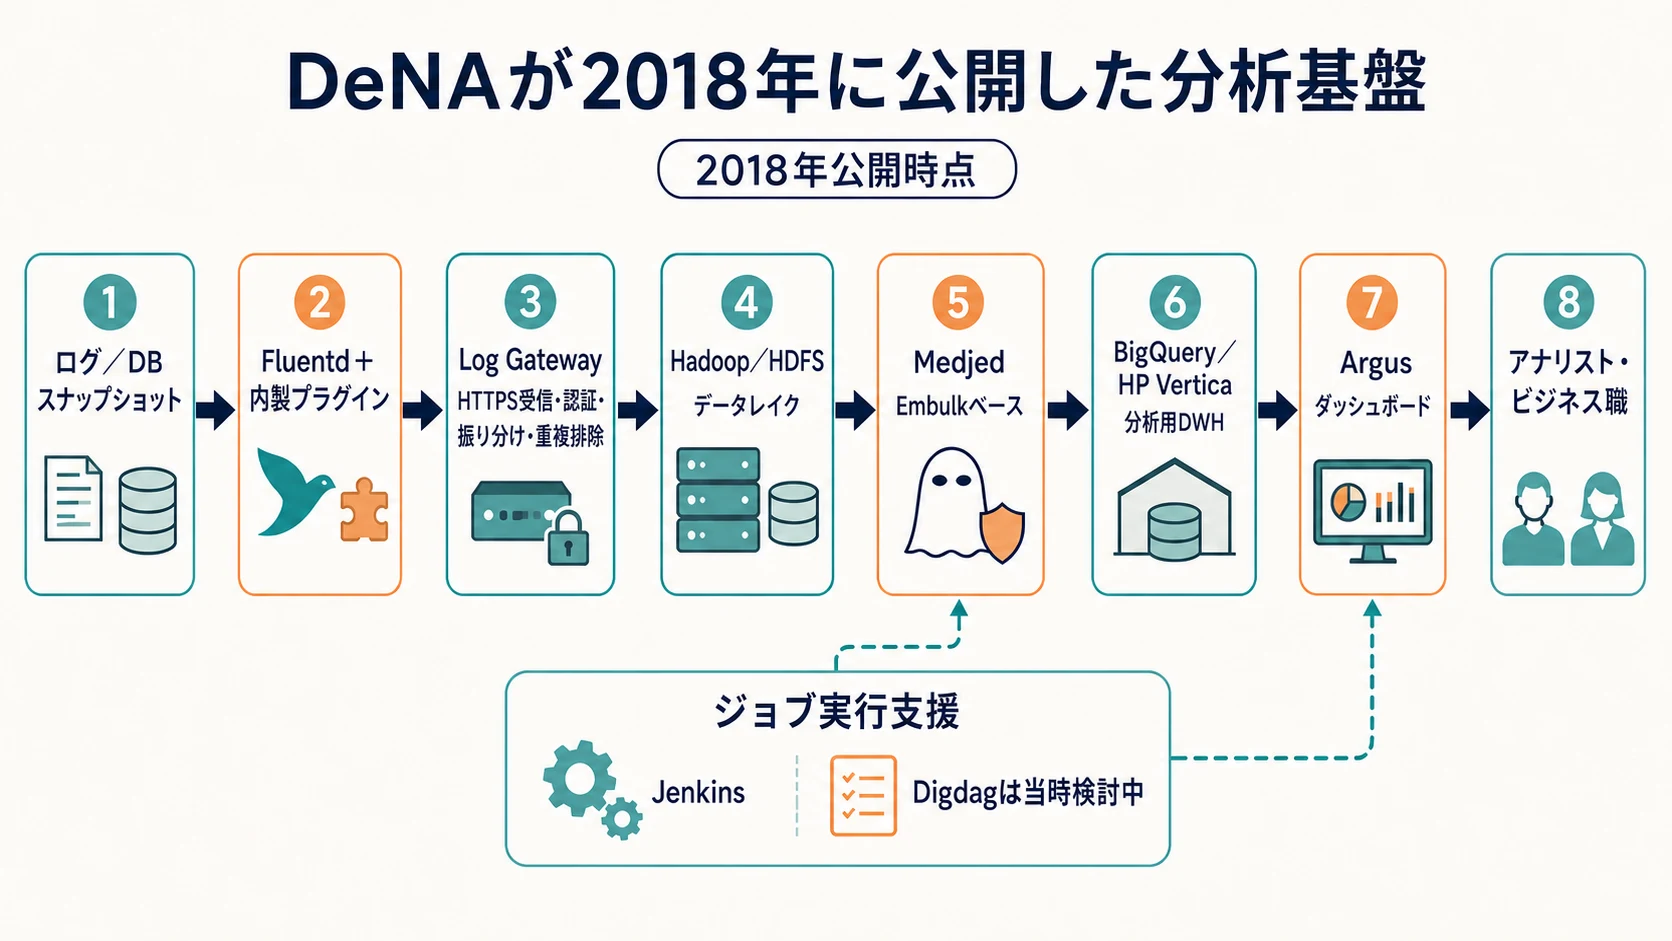
DeNAが2018年に公開した講演資料と講演記録は、四段階を具体的に見るうえで分かりやすい。当時の構成では、アプリケーションログをFluentdと内製プラグインで収集し、HTTPS POSTで全社共通のLog Gatewayへ送っていた。Log Gatewayは認証されたサービスからログを受け取り、サービス別の振り分けや重複排除を行ってHadoopのHDFSへ保存する。Hadoopは主にデータレイク、すなわち加工前のデータも含めて蓄える場所として使われていた。[2][3]
HDFSから分析用のBigQueryやHP Verticaへデータを送る役割は、内製のバルクロードツール「Medjed」が担った。MedjedはEmbulkを管理するWebアプリケーションであり、アナリストがGoogleスプレッドシートへ入出力のスキーマを書けば、実行用のYAML設定を生成できた。ダッシュボードは2014年頃から内製していた「Argus」で、BigQueryとVerticaへのクエリ結果を表やグラフにする。ジョブの定期実行にはJenkinsを使い、講演時点ではワークフローをコードで管理できるDigdagも候補として検討していた。[2][3]
この基盤は講演時点でゲーム以外の事業も含む60以上の部署・部門から利用されていた。分析基盤担当のミッションは、アナリストが容易かつ自由に分析できるインフラを提供することだった。プランナーが押さえるべき点は、HadoopやEmbulkの操作方法ではない。 収集、保管、加工、可視化を分離し、それぞれを専任チームが継続して支えることで、多数の利用者が同じ土台へアクセスできる という役割設計である。[3][4]
バンダイナムコエンターテインメントとCygames:同じ四段階でも道具は違う
バンダイナムコエンターテインメント向けにアイレットが構築した事例では、スマートフォン向けゲームごとに異なるDBやシステム環境からCloud Dataflowでデータを処理・統合し、BigQueryへ集約し、Lookerで分析・可視化する構成が採られた。導入事例は、タイトルの内容や特性によって環境が独自化していた状況から、運用側が個別環境の管理に追われず分析へ集中できる状態を目指したと説明している。[5]
Cygamesが2019年に公開した事例では、ゲームDBとサーバーログを分析用のAmazon Redshiftへ取り込み、分析、内製BI、カスタマーサポートに利用していた。同社が重視した要件は、必要な期間のデータを必要な時に取り込めることと、ゲーム側の急なスキーマ変更があっても取り込みを失敗させないことだった。Redshiftではコスト管理のため古いログを削除する一方、Amazon S3にアーカイブを残し、必要になれば再度ロードできる設計としていた。[6]
三社の製品名は異なるが、役割で見ると共通している。
| 役割 | DeNA(2018年公開) | バンダイナムコエンターテインメントの事例 | Cygames(2019年公開) |
|---|---|---|---|
| 収集・受け渡し | Fluentd、Log Gateway | 異なるゲーム環境から収集 | ゲームDB、サーバーログから収集 |
| 保管・加工 | Hadoop/HDFS、Medjed | Cloud Dataflow | Amazon S3、取り込み処理 |
| 分析用DWH | BigQuery、HP Vertica | BigQuery | Amazon Redshift |
| 利用面 | Argus | Looker | 分析、内製BI、CS対応 |
ツールの一致は目的ではない。自社のタイトル数、ログ量、クラウド環境、権限要件、担当者の技能に合わせて選べばよい。共通して必要なのは、どの段階が止まると数字が欠けるか、どこでデータが加工されるかを説明できる構造である。
3. 指標がバラバラになる構造的な原因
パイプラインは一本の直線として始まり、利用部門の近くで枝分かれする。Airbnbでは、基礎となるcore_dataの普及に伴って、その上に分析、予測、実験用の派生テーブルが次々と作られた。同じようなテーブルが既に存在するかを判断しにくく、上流の修正がすべての下流処理へ反映される保証もなかった。派生テーブルが増えるほど、データの来歴を追うことも難しくなった。[1]
ゲームのDAUを例にすると、次の選択が数字を変える。
| 定義項目 | 選択肢の例 | 数字が変わる理由 |
|---|---|---|
| 対象期間 | JSTの暦日、UTCの暦日、直近24時間 | 日付境界をまたぐユーザーの入り方が変わる |
| 活動の条件 | アプリ起動、認証成功、ホーム到達、チュートリアル完了 | 「活動した」とみなす段階が変わる |
| 一意な単位 | アカウントID、端末ID、プラットフォームID | 複数端末、未ログイン、再インストールの数え方が変わる |
| 除外条件 | 開発・QAアカウント、BOT、不正利用者、欠損ログ | 母集団に含める対象が変わる |
| 集計元 | 生ログ、日次集計テーブル、課金・会員DBとの結合表 | 遅延到着、重複排除、結合失敗の影響が変わる |
どの選択にも業務上の理由がありうる。ライブ運営はJST午前4時の日次更新に合わせたいかもしれない。グローバル経営はUTCで地域を比較したいかもしれない。マーケティングは広告SDKで観測できる端末を中心に見るかもしれない。問題は選択そのものではなく、異なる選択に同じ「DAU」という名前を付け、定義の差を表示しないことである。
さらに、ダッシュボードにはSQLや計算式を埋め込める場合が多い。新しい要望へ素早く応えるため、既存の集計を複製してフィルターを一つ変える。別部署も同じことをする。数か月後には、似た名前のカードが複数あり、どれが会議資料の正本か分からなくなる。 ダッシュボードの数は、画面の数であると同時に、独自定義が生まれうる分岐点の数でもある。
4. 指標を一箇所で定義する発想――メトリクスレイヤーという解決策
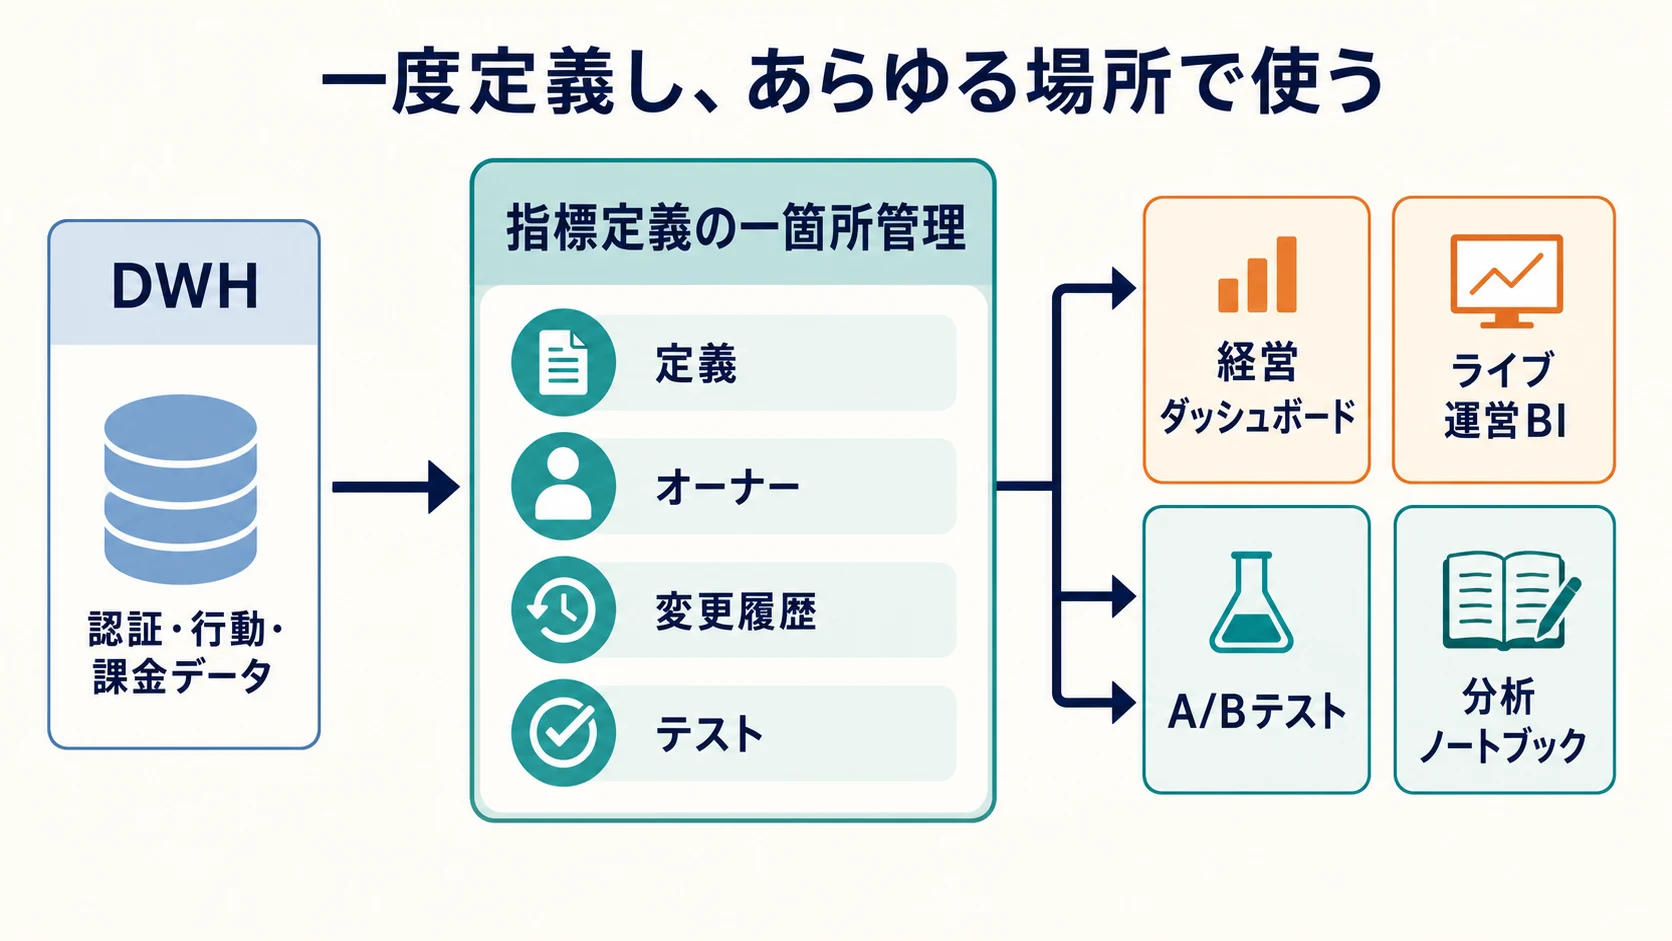
Airbnbはこの問題に対し、指標基盤「Minerva」を構築した。Minervaでは、重要な事業指標、分析軸、付随するメタデータを中央のGitHubリポジトリで管理し、社内の誰でも閲覧・更新できるようにした。変更にはコードレビュー、静的検証、テスト実行が組み込まれ、定義の版と変更履歴を追える。Minerva APIは集計済みデータと生の指標を共通の入口から提供する。[1]
中心にある考え方は 「一度定義し、あらゆる場所で使う」 ことである。AirbnbのダッシュボードであるSuperset、A/Bテスト基盤ERF、Metric Explorer、RやPythonの分析環境は、Minervaで定義された同じ指標を利用する。ダッシュボード用と実験用で同じ計算式を別々に書く構造を減らし、上流の定義変更を各利用先へ届ける。[1]
現在、この発想は一般に メトリクスレイヤー または セマンティックレイヤー と呼ばれ、複数のデータ製品で採用されている。例えばdbt Labsは、指標定義をBI画面からモデリング層へ移し、一箇所で定義した指標を異なる下流ツールやアプリケーションから参照する仕組みを「dbt Semantic Layer」として提供している。指標を中央で変更すれば、呼び出している各アプリケーションにも反映されるという設計である。[7]
専用基盤を構築できない会社でも、発想の核は導入できる。最小構成は一枚の指標定義台帳でよい。
| 項目 | DAU定義台帳の記入例 |
|---|---|
| 正式名称 | DAU(ライブ運営標準) |
| 目的 | 日次コンテンツへ到達した利用者規模の把握 |
| 対象期間 | JST午前4時から翌日午前3時59分59秒 |
| カウント対象 | 認証成功後、ホーム画面へ到達した一意なアカウントID |
| 除外条件 | QA・開発アカウント、利用停止済みBOT |
| 集計元 | analytics.daily_home_arrival |
| 更新時刻・遅延 | 毎日午前7時更新、遅延ログは翌日に再集計 |
| オーナー | ライブ運営分析担当 |
| 利用先 | 日次運営会議、イベント振り返りダッシュボード |
| 変更履歴 | 変更日、変更者、理由、影響を受けるダッシュボード |
台帳は利用ルールと組み合わせて初めて機能する。新しいダッシュボードは台帳の指標IDを参照し、定義変更はオーナーのレビューを通し、同名の独自指標を作るときは接尾辞を付ける、といった手続きが必要である。重要なのは高価な製品ではなく、 定義する場所と変更する手続きを一つにすること である。
5. プランナーとデータアナリストの協業体制――Aimingの実例
指標定義を一元化しても、利用者が数字を読めなければ意思決定は変わらない。Aimingの芝尾幸一郎氏がCEDEC 2018で発表した取り組みは、基盤と利用文化を一体で考えた例である。CEDEC公式のセッション説明では、データ分析チームの目標を、開発・運営を含むゲーム関係者の分析リテラシーを高め、社内に「データを分析する文化」を作ることとしている。分析入門、SQL講座、データ分析を扱う機関紙などを通じ、開発・運営が日々の業務で自ら分析できる状態を目指した。[8]
講演レポートによれば、Aimingは社員なら誰でも見られるBIツールを整備し、役割を次のように分けていた。運営担当はタイトル固有の知識と現場感覚を生かして基本的な集計・分析を行う。データ分析チームは、より複雑な分析・モデリングと社内向けレクチャーを担う。少人数の専門チームがすべての集計依頼を処理するのではなく、現場が自走できる範囲を広げ、専門家は専門性が必要な課題へ集中する設計である。[9]
この分担は「全員が高度なSQLを書く」という意味ではない。プランナーが目指す範囲は、既存ダッシュボードの条件を正しく選ぶ、定義台帳を読んで数字の意味を説明する、基本的な集計で仮説を確かめる、複雑な因果推論や予測モデルは分析担当へ相談する、という段階で設定できる。
Aimingの独自KPIも、指標を自社の課題に合わせて設計する視点を示している。講演レポートでは、 FQ5 を5日間連続ログインユーザー数として、定着につながる指標に位置付け、最重視していた。また MRPPU は、課金ユーザー1人当たりの売上を平均値ではなく中央値で捉える指標として紹介された。平均値のARPPUは少数の重課金ユーザーによる大きな値の影響を受けやすいため、典型的な課金ユーザーの姿を見る用途では中央値を使うという判断である。[9]
FQ5やMRPPUはAimingの課題に合わせた指標であり、他社は自社の目的から設計する。連続ログインを重視しないゲームにFQ5を置けば、プロダクトの狙いと指標がずれる。売上総額を予測する局面では、中央値だけでは大口売上の影響を捉えられない。 指標は目的に答えるための道具であり、有名な略語を増やすことがKPI設計ではない。 自社で解きたい問いを先に置き、その問いに合う集計方法を分析担当と選ぶべきである。
6. ダッシュボード運用を「作って終わり」にしないために
ダッシュボードの公開日は運用の開始日である。DeNAの2018年の講演では、分析基盤担当がArgus、Medjed、Jenkinsの権限設定、サーバー運用、問い合わせ対応まで担っていた。利用者向けのSlack窓口を設け、アナリストだけでなくビジネス職やバックオフィスからも相談を受けていた。基盤チームの仕事は画面を作ることにとどまらず、利用者が分析を続けられる状態を保つことだった。[4]
Aimingも、BIを全社員へ公開するだけでなく、データ分析講座、SQL講座、社内報「モノリスさん」を通じて接点を作り続けた。講演レポートでは、社内報が勉強会へ参加しにくい人にも届く入口として機能したと説明されている。[9] 操作説明を一度実施するだけでなく、実際の業務で数字を使う機会を反復して作ることが利用定着につながる。
継続運用には、少なくとも四つの仕事がある。
- 利用を支える:新任者向けの読み方、SQL講座、相談窓口、代表的な分析例を用意する。
- 定義を保守する:イベント仕様、タイムゾーン、BOT除外、タイトル統合などの変更に合わせ、定義と変更履歴を更新する。
- データ品質を監視する:更新時刻、欠損、重複、急変、取り込み失敗を検知し、ダッシュボード上でも最終更新時刻を示す。
- 不要物を整理する:使われないログ、派生テーブル、重複ダッシュボードを棚卸しし、オーナー不在のものは廃止候補にする。
Cygamesの事例にある、古いログをRedshiftから削除しつつS3にアーカイブする設計は、整理と復元可能性を両立した例である。AirbnbのMinervaも、指標の利用状況に基づく保持と自動廃止の機能を備えていた。[6][1] 「いつか使うかもしれない」を理由にすべてを高速なDWHと現役ダッシュボードへ残せば、費用だけでなく、利用者が正しい指標を探す負担も増える。
廃止は、最終利用日、参照元、代替指標、オーナーを確認し、一定期間の予告を出してから実施する。アーカイブにも保持期間を設定する。法令、プライバシー、契約、分析価値、復元費用を踏まえ、保存する範囲と期間を決める必要がある。
7. まとめ:新規ダッシュボード・指標設計前の確認表
CEOへ一つの数字を返すために必要なのは、一つの巨大なダッシュボードではない。ログからDWHまでの経路、指標定義の正本、変更手続き、利用者教育、廃止までを一つの運用としてつなぐことである。新しいダッシュボードやKPIを企画するときは、次を確認する。
- 問い:この指標で、誰がどの意思決定を行うのかを一文で書いたか
- 対象期間:暦日、日次リセット、直近24時間、イベント期間などの境界とタイムゾーンを明記したか
- カウント対象:起動、認証、ホーム到達、チュートリアル完了など、「活動」の成立条件を決めたか
- 一意な単位:アカウント、端末、プラットフォームIDのどれで重複を除くか決めたか
- 除外条件:QA・開発アカウント、BOT、不正利用、欠損ログをどう扱うか決めたか
- 集計元:参照する生ログ、テーブル、列、結合条件を特定したか
- 既存指標との関係:似た指標が既にないか、重複するなら統合できないか、併存するなら名前で区別できるか
- 正本:定義を一箇所で参照でき、ダッシュボードやA/Bテストが同じ定義を利用できるか
- 変更履歴:誰が、いつ、なぜ定義を変え、どの期間と利用先に影響したかを追えるか
- オーナー:定義、データ品質、ダッシュボードの問い合わせ先と承認者が決まっているか
- 鮮度:更新時刻、遅延ログの再集計、欠損時の表示、速報値と確定値の区別を決めたか
- 利用者の自走範囲:プランナーが閲覧だけを行うのか、条件変更、基本集計、SQLまで担うのかを決め、教育を用意したか
- 廃止条件:最終利用日、代替先、保持期間、アーカイブ方法を定期的に見直せるか
数字が食い違った会議では、最初に値の大小を争う必要はない。「そのDAUの定義IDは何か」「対象日はどのタイムゾーンか」「どのテーブルから、いつ更新されたか」を確認すれば、相違点を構造として特定できる。プランナーが担うのは、パイプラインを実装することではなく、 意思決定に使う言葉と数字が同じ意味で接続されているかを問い続けること である。
References
1. How Airbnb achieved metric consistency at scale - Airbnb Engineeringが、CEOへの回答がチーム間で食い違った経緯、派生テーブルの増殖、Minervaの指標定義・API・利用先を解説した公式記事。
2. TD Tech Talk 2018: DeNA AI&Analytics Infrastructure - DeNAの松木秀憲氏らによる講演資料。Fluentd、Log Gateway、HDFS、Medjed、BigQuery/Vertica、Argus、Jenkinsの構成を掲載。
3. DeNAのデータ分析基盤 あらゆるサービスのログを蓄積・分析するインフラの仕組み - 「2020年代に向けたDeNAの分析基盤」講演前半の書き起こし。公開当時の構成、60以上の部署・部門での利用、各ツールの役割を説明。
4. DeNAが目指すこれからの分析基盤 2020年代に向けたインフラのあるべき姿 - 同講演後半の書き起こし。分析基盤担当の運用、権限設定、利用者支援、Slack窓口を説明。
5. 株式会社バンダイナムコエンターテインメント様のGoogle Cloudを活用したデータ分析プラットフォームの構築事例 - アイレットによる導入事例。Cloud Dataflow、BigQuery、Lookerの構成と、異なるゲーム環境からの統合を説明。
6. ゲーム運用を影から支えるCygamesのデータ分析基盤について - Cygames Engineers’ Blogによる公式記事。Redshiftへのアドホック取り込み、スキーマ変更への対応、S3アーカイブを説明。
7. dbt Semantic Layer - 指標定義をモデリング層へ集約し、複数の下流ツールやアプリケーションから一貫して参照する仕組みを説明するdbt Labs公式ドキュメント。
8. データを分析する文化を作る―開発運営が自分でデータを分析してもらうためにしたこと― - CEDEC公式デジタルライブラリーのセッションページ。Aimingの芝尾幸一郎氏による講演趣旨、対象者、社内講座と機関紙の取り組みを掲載。
9. 【CEDEC 2018】「開発・運営が自らデータ分析する文化を!」 - gamebizによる講演レポート。運営と分析チームの役割分担、全社員向けBI、FQ5、MRPPU、SQL講座、社内報を紹介。
この文書は、Perplexity、Claude、OpenAI Codex の3つのAIの支援を受けて著述されたものです。引用画像を除き、MIT License にて提供されています。